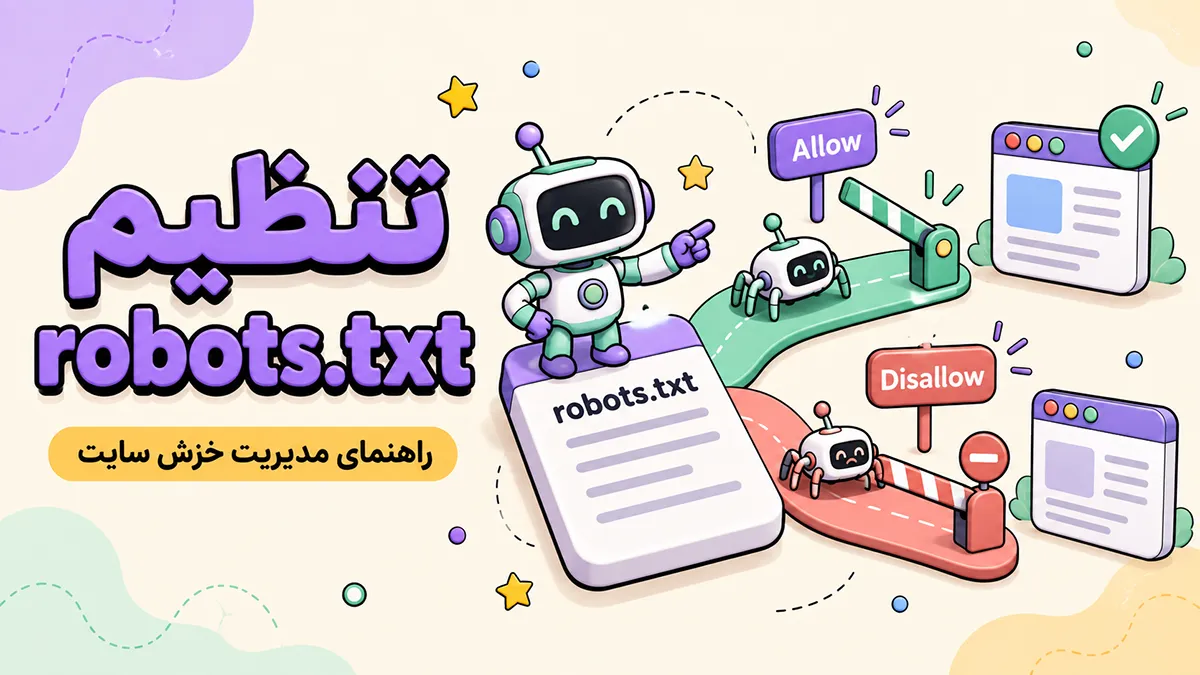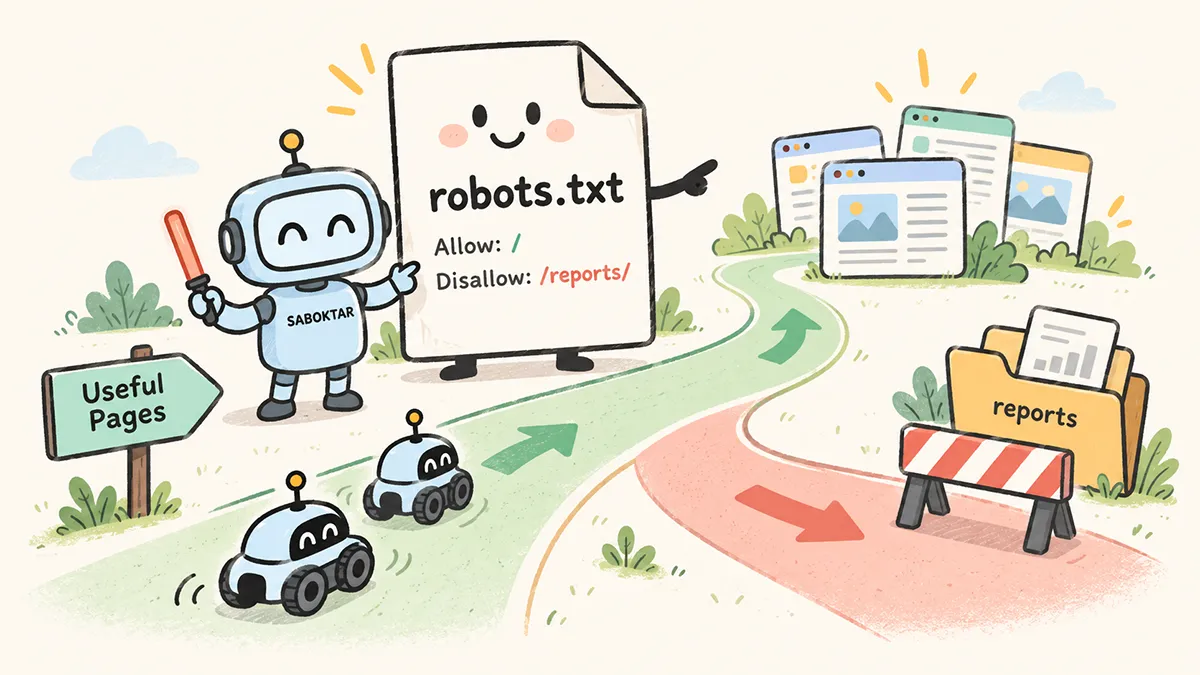
فایل robots.txt یک فایل متنی در ریشه سایت است که به خزندههای سازگار، مثل رباتهای موتورهای جستجو، میگوید کدام مسیرها را میتوانند بررسی کنند. کاربرد اصلی آن مدیریت خزش است؛ یعنی کنترل رفتوآمد رباتها در سایت. این فایل بهتنهایی نه یک صفحه را از نتایج گوگل حذف میکند و نه از اطلاعات خصوصی محافظت میکند.
اگر اسم این فایل را در سرچ کنسول یا تنظیمات افزونه سئو دیدهاید، لازم نیست نگران پیچیدگی آن باشید. کافی است چند دستور اصلی را بشناسید و قبل از هر تغییر، بدانید دقیقاً چه چیزی را میخواهید محدود کنید. در این راهنما با مثالهای روشن یاد میگیریم چطور قوانین را بنویسیم، در وردپرس اجرا کنیم و نتیجه را بررسی کنیم.
قبل از شروع، این سه تفاوت را به خاطر بسپارید:
- خزش یا Crawl: ربات به یک آدرس سر میزند و محتوای آن را دریافت میکند.
- ایندکس یا Index: موتور جستجو اطلاعات صفحه را پردازش میکند و ممکن است آن را در فهرست خود نگه دارد.
- رتبهبندی: موتور جستجو تصمیم میگیرد هنگام جستجوی کاربر، کدام نتایج را با چه ترتیبی نمایش دهد.
robots.txt مستقیماً با مرحله اول سروکار دارد. محدود کردن خزش، دستور حذف از ایندکس نیست و افزایش رتبه را هم تضمین نمیکند. برای آشنایی بیشتر با این مسیر، مقاله موتورهای جستجو چگونه کار میکنند؟ را بخوانید.
خزندههای معتبر مثل رباتهای جستجوی گوگل این قوانین را رعایت میکنند، اما رباتهای مخرب ممکن است آنها را نادیده بگیرند. بنابراین برای بخشهای خصوصی، به ورود با رمز و کنترل دسترسی واقعی نیاز دارید. راهنمای مقدماتی گوگل درباره robots.txt
فایل robots.txt چه شکلی دارد؟
یک فایل ساده میتواند فقط چند خط داشته باشد:
User-agent: *
Disallow: /internal-reports/

Sitemap: https://example.com/sitemap.xml
این مثال فرضی میگوید:
- قوانین برای خزندههایی است که گروه اختصاصیتری ندارند.
- مسیر
/internal-reports/و آدرسهای زیرمجموعه آن نباید خزش شوند. - نقشه سایت در آدرس مشخصشده قرار دارد.
مسیرهای دیگر بهصورت پیشفرض مجاز هستند؛ لازم نیست تکتک مقالهها، محصولات و دستهبندیها را با Allow مجاز کنید. نام مسیر و آدرس نقشه سایت در این مثال آموزشی است و باید با ساختار واقعی سایت شما هماهنگ شود.
نکته: اگر گزارشهای این پوشه محرمانه هستند، همین قانون کافی نیست. robots.txt خودش عمومی است و حتی میتواند نام مسیرهای نوشتهشده در آن را به دیگران نشان دهد.
User-agent در robots.txt چیست؟
User-agent مشخص میکند هر گروه از قوانین برای کدام خزنده نوشته شده است. در این فایل معمولاً نام کوتاه خزنده را مینویسیم؛ لازم نیست رشته کامل معرفی مرورگر یا ربات را وارد کنیم.
چند نمونه کاربردی:
Googlebot: خزنده اصلی جستجوی گوگل.Googlebot-Image: خزنده تصاویر گوگل.Bingbot: خزنده موتور جستجوی بینگ.*: گروه عمومی برای خزندههایی که گروه اختصاصی منطبق ندارند.
مثلاً در فایل زیر، Googlebot قوانین گروه خودش را دنبال میکند:
User-agent: *
Disallow: /internal-reports/

User-agent: Googlebot
Disallow: /internal-reports/
Disallow: /crawl-test/
در این مثال، خزش گزارشها برای هر دو گروه محدود شده، اما مسیر آزمایشی فقط برای Googlebot بسته است. تکرار قانون گزارشها عمدی است: گروه اختصاصی Googlebot محدودیتهای گروه عمومی را خودکار به ارث نمیبرد.
اگر برای Googlebot چند گروه همسطح بنویسید، گوگل قوانین آنها را با هم ترکیب میکند. برای خوانایی و کاهش خطا، بهتر است قوانین هر خزنده را تا جای ممکن یکجا نگه دارید.
Directive در robots.txt چیست؟
Directive یعنی دستور؛ همان چیزی که بعد از مشخص کردن خزنده، رفتار موردنظر شما را تعریف میکند. برای بیشتر سایتها این سه مورد کافی است:
- Disallow: محدود کردن خزش یک مسیر.
- Allow: مجاز کردن یک مسیر، بهویژه بهعنوان استثنای یک محدودیت کلیتر.
- Sitemap: معرفی آدرس کامل نقشه سایت.
هر دستور را در یک خط جدا بنویسید. برای توضیحی که قرار نیست اجرا شود، از علامت # استفاده کنید:
# Limit crawling of generated reports
User-agent: *
Disallow: /generated-reports/
توضیح کوتاه کمک میکند چند ماه بعد هم یادتان باشد چرا یک مسیر را محدود کردهاید.
دستور Disallow در robots.txt
Disallow به خزنده میگوید یک مسیر مشخص را بررسی نکند. فرض کنید سایت شما خروجیهای موقتی در پوشه گزارشها تولید میکند و تصمیم گرفتهاید خزش آنها را محدود کنید:
User-agent: *
Disallow: /generated-reports/
این قانون با آدرسهای زیر مطابقت دارد:
/generated-reports/
/generated-reports/daily-summary/
/generated-reports/export.csv
اما مسیر /blog/ را محدود نمیکند. Disallow بر اساس الگوی آدرس عمل میکند؛ محتوای صفحه یا نام دستهبندی در پیشخوان وردپرس را تشخیص نمیدهد.
تفاوت Disallow خالی با مسدود کردن کل سایت
این دو حالت نتیجه کاملاً متفاوتی دارند. در حالت اول محدودیتی تعریف نشده است:
User-agent: *
Disallow:
اما نمونه زیر خزش همه مسیرها را برای خزندههای مشمول گروه میبندد؛ آن را روی سایت عمومی که باید در جستجو دیده شود قرار ندهید:
User-agent: *
Disallow: /
یک اسلش تفاوت کوچکی در ظاهر است، اما میتواند دسترسی ربات به تمام مقالهها و محصولات را تغییر دهد.
دستور Allow در robots.txt
Allow وقتی کاربرد دارد که بخواهید در یک مسیر بسته، استثنا ایجاد کنید. مثلاً همه گزارشهای تولیدشده نباید خزش شوند، اما راهنمای استفاده از آنها باید در دسترس بماند:
User-agent: *
Disallow: /generated-reports/
Allow: /generated-reports/help/
نتیجه این تنظیم:
/generated-reports/daily-summary/برای خزش بسته است./generated-reports/help/برای خزش باز است.- زیرمسیرهای
/generated-reports/help/هم با قانون Allow مطابقت دارند.
دقت کنید که مجاز بودن خزش به معنی ایندکس شدن قطعی نیست؛ صفحه ممکن است noindex باشد یا به دلایل دیگری وارد نتایج نشود.
وقتی Allow و Disallow تداخل دارند، کدام اولویت دارد؟
در گوگل، مسیر منطبقِ مشخصتر و طولانیتر اولویت دارد. اگر دو قانون متعارض از نظر مشخص بودن برابر باشند، قانون کممحدودیتتر، یعنی Allow، برنده میشود.
User-agent: *
Disallow: /reports/
Allow: /reports/public/
برای آدرس /reports/public/annual/ قانون Allow اعمال میشود، چون مسیر مشخصتری دارد. اما /reports/monthly/ همچنان مسدود است.
اگر هر دو مسیر یکسان باشند، خزش مجاز میشود:
User-agent: *
Disallow: /reports/
Allow: /reports/
جابجا کردن ترتیب این دو خط نتیجه را عوض نمیکند. بهتر است بهجای نگه داشتن قانونهای متناقض، فایل را ساده کنید تا بعداً برداشت اشتباه پیش نیاید.
تفاوت اسلش، ستاره و علامت دلار
در تطبیق آدرسها این جزئیات مهماند:
/reportsمیتواند با/reports-old/هم منطبق شود./reports/زیرمسیرهای همین پوشه را پوشش میدهد، اما با/reports-old/منطبق نیست.- مسیرها به حروف بزرگ و کوچک حساساند؛
/Reports/با/reports/یکسان نیست. *در الگوی مسیر جای صفر یا چند کاراکتر مینشیند.$پایان آدرس را مشخص میکند.
مثلاً این نمونه فقط آدرسهایی را محدود میکند که دقیقاً با پسوند کوچک .csv تمام شوند:
User-agent: *
Disallow: /*.csv$
در نتیجه /exports/report.csv مشمول آن است، اما /exports/report.csv?download=1 نیست. همین تفاوت نشان میدهد چرا باید قوانین را با آدرسهای واقعی آزمایش کنید. جزئیات رفتار گوگل را میتوانید در مستندات تفسیر robots.txt بررسی کنید.
دستور Sitemap در robots.txt
Sitemap آدرس نقشه سایت را به موتور جستجو معرفی میکند. نقشه سایت معمولاً فهرستی از URLهای مهم یا آدرس نقشههای کوچکتر را در اختیار خزنده میگذارد:
Sitemap: https://example.com/sitemap_index.xmlسه نکته را رعایت کنید:
- آدرس را کامل، همراه با پروتکل و نام دامنه بنویسید.
- آدرس واقعی نقشه سایت را وارد کنید؛ نام آن در همه سایتها یکسان نیست.
- لازم نیست Sitemap را برای هر User-agent تکرار کنید؛ این دستور به گروه خاصی محدود نیست.
اگر یک فایل «فهرست نقشههای سایت» دارید، معرفی همان فایل معمولاً کافی است. در صورت نیاز میتوانید چند نقشه را جداگانه هم معرفی کنید:
Sitemap: https://example.com/post-sitemap.xml
Sitemap: https://example.com/page-sitemap.xml
Sitemap: https://example.com/product-sitemap.xml
قرار دادن یک URL در نقشه سایت، محدودیت Disallow یا دستور noindex آن را خنثی نمیکند. بهتر است نقشه سایت، تنظیمات ایندکس و قوانین خزش با هم هماهنگ باشند.
دستورهایی که گوگل در robots.txt پشتیبانی نمیکند
هر دستوری که در نمونههای اینترنتی دیده میشود، برای گوگل معتبر نیست. سه موردی که بیشتر باعث سوءتفاهم میشوند، Crawl-delay، Noindex و Nofollow هستند.
Crawl-delay؛ راه کنترل Googlebot نیست
گوگل دستور Crawl-delay را در robots.txt پشتیبانی نمیکند. بنابراین با اضافه کردن آن نمیتوانید فاصله درخواستهای Googlebot را تنظیم کنید. اگر فشار خزش روی سرور زیاد است، ابتدا لاگها و وضعیت منابع را بررسی کنید تا معلوم شود درخواستها واقعاً از کدام ربات میآیند.
Noindex؛ باید در صفحه یا پاسخ سرور باشد
اگر هدف شما این است که یک صفحه در نتایج گوگل نمایش داده نشود، noindex را داخل robots.txt ننویسید. برای صفحه HTML میتوان از این متاتگ در بخش head استفاده کرد:
<meta name="robots" content="noindex">در وردپرس معمولاً تنظیم noindex همان صفحه در افزونه سئو، سادهتر از ویرایش دستی کد است. گذاشتن این کد داخل بدنه مقاله یا بلوک کد، noindex را روی صفحه اجرا نمیکند.
برای فایلهایی مثل PDF هم میتوان از هدر پاسخ HTTP استفاده کرد:
X-Robots-Tag: noindexاین هدر باید در پاسخ سرور ارسال شود. در هر دو روش، گوگل باید بتواند URL را بخزد تا دستور را ببیند؛ پس همان URL را همزمان با robots.txt نبندید. راهنمای رسمی noindex
Nofollow؛ دستور معتبر این فایل نیست
نوشتن Nofollow در robots.txt روش کنترل لینکها نیست. برای یک لینک مشخص، این ویژگی در خود تگ لینک قرار میگیرد:
<a href="https://example.com" rel="nofollow">مشاهده صفحه</a>این ویژگی هم جایگزین noindex یا کنترل دسترسی نیست. صرفاً برای جلوگیری از دیده شدن یک صفحه، سراغ nofollow نروید.
آیا به فایل robots.txt نیاز دارید؟
داشتن robots.txt برای همه سایتها الزامی نیست. یک سایت شرکتی کوچک با چند صفحه خدمات و وبلاگ، لزوماً به دهها قانون محدودکننده نیاز ندارد. کاربرد اصلی این فایل وقتی پررنگتر میشود که آدرسهای زیاد و غیرضروری تولید میکنید.
مواردی که ارزش بررسی دارند:
- خروجیهای موقتی و گزارشهایی که خزش آنها لازم نیست.
- ترکیبهای متعدد فیلتر و مرتبسازی در فروشگاهها.
- مسیرهای ماشینی که محتوای مفیدی برای جستجو ندارند.
- درخواستهای تکراری خزنده به URLهایی که در لاگ سرور شناسایی کردهاید.
فرض کنید یک فروشگاه با انتخاب رنگ، اندازه و ترتیب نمایش، برای یک دسته محصول صدها ترکیب URL تولید میکند. پیش از بستن همه آنها باید بررسی کنید آیا بعضی ترکیبها، مثل صفحه «کفش دویدن زنانه»، ارزش جستجوی مستقلی دارند یا نه. قانون کلی برای همه پارامترها ممکن است همان صفحات ارزشمند را هم ببندد.
برای صفحات تکراری، گاهی اصلاح لینکسازی، canonical یا noindex انتخاب مناسبتری است. robots.txt جایگزین همه ابزارهای سئوی سایت نیست؛ ابزار درست را بر اساس هدف انتخاب کنید.
چگونه فایل robots.txt سایت را پیدا کنیم؟
به انتهای آدرس اصلی سایت، /robots.txt اضافه کنید:
https://example.com/robots.txtاگر سایت شما با www باز میشود، همان نسخه را بررسی کنید:
https://www.example.com/robots.txtخروجی باید متن قوانین باشد. نمایش صفحه اصلی، فرم ورود یا صفحه خطای گرافیکی بهجای این متن، نشانهای است که باید مسیر یا تنظیمات سرور را بررسی کنید.
خطای ۴۰۴ برای robots.txt معمولاً به این معنی است که گوگل محدودیت خزشی از این فایل دریافت نمیکند. اما خطای سرور، مثل ۵۰۳، وضعیت متفاوتی دارد و میتواند خزش را مختل کند. پس «فایل نداریم» را با «سرور نمیتواند فایل را تحویل دهد» یکی ندانید.
چگونه فایل robots.txt بسازیم یا ویرایش کنیم؟
اول هدف هر قانون را مشخص کنید؛ بعد سراغ نوشتن فایل بروید. یک روال ساده برای ساخت دستی:
- اگر فایل فعلی وجود دارد، از متن آن نسخه پشتیبان بگیرید.
- در یک ویرایشگر متن ساده، قوانین لازم را بنویسید.
- فایل را با نام دقیق
robots.txtو کدگذاری UTF-۸ ذخیره کنید. - آن را در ریشه وب همان دامنه قرار دهید.
- آدرس عمومی فایل را باز کنید و مطمئن شوید آخرین نسخه نمایش داده میشود.
- تأثیر قوانین را روی چند صفحه مهم و چند مسیر هدف بررسی کنید.
فایل نباید سند Word، صفحه HTML یا فایلی با نام robots.txt.txt باشد. گوگل مراحل ساخت و بررسی را در راهنمای ایجاد robots.txt توضیح داده است.
تنظیم robots.txt در وردپرس
اگر سایت شما با وردپرس ساخته شده، ممکن است robots.txt بهصورت مجازی تولید شود؛ یعنی در مرورگر آن را ببینید، اما فایل فیزیکی متناظری در ریشه هاست نباشد.
مسیرهای رایج ویرایش در افزونهها:
- Rank Math: بخش Rank Math SEO، سپس General Settings و Edit robots.txt. اگر گزینه را نمیبینید، حالت Advanced را بررسی کنید.
- Yoast SEO: بخش Yoast SEO، سپس Tools و File Editor؛ در صورت نیاز گزینه ساخت فایل را انتخاب کنید.
Rank Math نسخه مجازی را مدیریت میکند؛ وجود فایل فیزیکی در ریشه میتواند باعث شود تغییرات افزونه در خروجی سایت دیده نشوند. پیش از جابجایی یا حذف فایل فیزیکی، از قوانینش پشتیبان بگیرید. راهنمای Rank Math
در Yoast هم ممکن است بهدلیل محدودیت دسترسی نوشتن یا غیرفعال بودن ویرایش فایل، این بخش در دسترس نباشد. در این حالت، ویرایش از طریق مدیریت فایل هاست یک مسیر جایگزین است. راهنمای Yoast
یک نمونه پایه برای بررسی در سایت وردپرسی
نمونه زیر یک نقطه شروع رایج است، نه نسخهای که بدون بررسی برای همه سایتها مناسب باشد:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
در این نمونه، مسیر مدیریت محدود است و فایل admin-ajax.php استثنا شده؛ بعضی امکانات بخش عمومی سایت ممکن است از این فایل استفاده کنند. آدرس Sitemap را با آدرس واقعی نقشه سایت خودتان جایگزین کنید.
صرفاً برای «بهینهتر شدن»، پوشههای wp-content، فایلهای CSS و JavaScript یا تصاویر را به فهرست ممنوعه اضافه نکنید. این منابع ممکن است برای نمایش و درک درست صفحه لازم باشند.
فایل robots.txt را کجا قرار دهیم؟
فایل باید در ریشه همان میزبان در دسترس باشد. این دو آدرس میتوانند فایلهای مستقل داشته باشند:
https://example.com/robots.txt
https://shop.example.com/robots.txt
قوانین دامنه اصلی خودکار به زیردامنه فروشگاه منتقل نمیشوند. پروتکل و پورت هم در محدوده اعمال قوانین نقش دارند؛ نسخههای HTTP و HTTPS را بدون بررسی یکسان فرض نکنید.
قرار دادن فایل در مسیر زیر، آن را به فایل کنترل خزش کل سایت تبدیل نمیکند:
https://example.com/blog/robots.txtدر هاست، نام پوشه ریشه ممکن است public_html باشد، اما برای دامنههای افزوده یا تنظیمات دیگر فرق کند. معیار اصلی، قابلدسترسی بودن فایل در آدرس درست روی سایت است.
بعد از تغییر، چطور مطمئن شویم فایل درست کار میکند؟
ذخیره شدن تنظیمات در افزونه پایان کار نیست. خروجی عمومی و وضعیت دسترسی خزنده را هم بررسی کنید:
- متن زنده فایل را ببینید: آدرس robots.txt را باز کنید و قوانین جدید را با نسخه ذخیرهشده مقایسه کنید.
- کش را بررسی کنید: اگر متن قدیمی است، کش افزونه، سرور یا CDN را در نظر بگیرید.
- صفحات مهم را آزمایش کنید: صفحه اصلی، یک خدمت، یک مقاله و در فروشگاه یک محصول را انتخاب کنید؛ در URL Inspection سرچ کنسول، تست زنده بگیرید و وضعیت مجاز بودن خزش را ببینید.
- مسیرهای هدف را بررسی کنید: فقط باز بودن صفحات مهم کافی نیست؛ مطمئن شوید قانون، مسیر موردنظر را هم پوشش میدهد.
- گزارش robots.txt را ببینید: خطاها و زمان آخرین دریافت فایل را در سرچ کنسول بررسی کنید. در صورت نیاز امکان درخواست دریافت مجدد هم وجود دارد.
تست زنده دسترسی فعلی را بررسی میکند؛ نتیجه آن تضمین ایندکس شدن نیست. امکانات گزارش فایل در راهنمای robots.txt سرچ کنسول توضیح داده شده است.
برای یک بررسی دستی، این سه آدرس فرضی را کنار قانون Disallow: /reports/ بگذارید: مسیر /reports/monthly/ باید بسته باشد، /reports-old/ نباید مشمول شود و /blog/ باید باز بماند. چنین مقایسهای کمک میکند اثر ناخواسته الگوها را زودتر پیدا کنید.
اشتباهات رایجی که بهتر است از آنها دوری کنید
- بستن کل سایت بعد از پایان طراحی: قوانین محیط آزمایشی را هنگام انتشار بررسی کنید.
- استفاده از Disallow برای حذف از گوگل: اگر هدفتان کنترل ایندکس است، ابزار مناسب همان کار را به کار ببرید.
- مسدود کردن صفحهای که noindex دارد: گوگل برای دیدن noindex به دسترسی نیاز دارد.
- کپی کردن robots.txt یک سایت دیگر: نام پوشهها، پارامترها و نیازهای خزش پروژهها یکسان نیست.
- بستن منابع لازم برای نمایش صفحه: مسیر فایلهای قالب، اسکریپتها و تصاویر را بیدلیل محدود نکنید.
- اعتماد به robots.txt برای امنیت staging: محیط آزمایشی خصوصی باید کنترل دسترسی واقعی داشته باشد.
- اضافه کردن گروه اختصاصی بدون قوانین لازم: محدودیتهای گروه عمومی را برای Googlebot اختصاصی دوباره بررسی کنید.
robots.txt چه ارتباطی با جستجوی هوش مصنوعی و AIO دارد؟
برای اینکه محتوای شما شانس حضور در پاسخهای مبتنی بر جستجو را داشته باشد، موتور جستجو باید بتواند به محتوای لازم دسترسی پیدا کند. بنابراین بستن ناخواسته صفحات مهم میتواند این مسیر را هم مختل کند.
در مورد AI Overviews و AI Mode گوگل، صفحه باید ایندکس شده و واجد شرایط نمایش در جستجو همراه با اسنیپت باشد. گوگل برای این قابلیتها فایل متنی مخصوص هوش مصنوعی یا اسکیمای ویژهای الزامی نکرده است. راهنمای گوگل درباره قابلیتهای هوش مصنوعی در جستجو
از نظر کاربردی، روی این موارد تمرکز کنید:
- پاسخ اصلی را روشن و زودهنگام ارائه کنید.
- هر بخش را حول یک سؤال مشخص بنویسید.
- مثال دقیق، توضیح نتیجه و منابع معتبر داشته باشید.
- دسترسی به محتوای مهم و منابع لازم برای نمایش آن را باز نگه دارید.
این کارها فهم و استفاده از محتوا را آسانتر میکنند؛ تضمینی برای نقل شدن در پاسخ هوش مصنوعی نیستند. همچنین قوانین خزندههای سرویسهای دیگر را باید در مستندات همان سرویس بررسی کرد؛ تنظیم Googlebot به معنی کنترل همه رباتهای هوش مصنوعی نیست.
پرسشهای متداول
چرا با وجود Disallow، هنوز آدرس صفحه در گوگل دیده میشود؟
ممکن است گوگل آدرس را از لینکهای دیگر شناخته باشد یا صفحه از قبل ایندکس شده باشد. Disallow اجازه دریافت محتوا را محدود میکند و دستور حذف نتیجه نیست. برای صفحهای که باید در سایت بماند اما در جستجو نباشد، noindex همراه با امکان خزش را بررسی کنید.
چرا تغییرات افزونه در robots.txt نمایش داده نمیشود؟
سه احتمال را بررسی کنید: فایل فیزیکی بر خروجی مجازی اولویت گرفته، کش نسخه قدیمی را نشان میدهد یا نسخه دیگری از دامنه را باز کردهاید. خروجی عمومی فایل معیار بررسی است، نه صرفاً پیام ذخیره موفق در افزونه.
آیا فایل robots.txt میتواند از اطلاعات کاربران محافظت کند؟
خیر. این فایل عمومی است و مانع درخواست مستقیم کاربران یا رباتهای ناسازگار نمیشود. اطلاعات حساب، سفارشها و گزارشهای خصوصی باید با احراز هویت و کنترل مجوز محافظت شوند.
آیا حذف robots.txt باعث ایندکس شدن همه صفحات میشود؟
خیر. برداشتن محدودیت خزش، فقط یکی از موانع احتمالی را برطرف میکند. noindex، خطاهای سرور و عوامل دیگر همچنان ممکن است مانع ایندکس شوند.
تغییرات robots.txt فوراً اجرا میشوند؟
لزوماً نه. خزنده ممکن است هنوز نسخه کششده را استفاده کند. زمان آخرین دریافت فایل را در گزارش سرچ کنسول ببینید و پس از تغییر مهم، وضعیت دسترسی صفحات را دوباره بررسی کنید.
جمعبندی: هر قانون باید هدف مشخصی داشته باشد
برای تنظیم درست robots.txt، از این سؤال شروع کنید: «میخواهم خزش یک مسیر را محدود کنم، صفحهای را از نتایج خارج کنم یا از اطلاعات خصوصی محافظت کنم؟» پاسخ این سؤال مشخص میکند که robots.txt ابزار مناسب شما هست یا باید سراغ noindex و کنترل دسترسی بروید.
برای بیشتر سایتها، چند قانون روشن و آزمایششده از یک فایل طولانی و مبهم کاربردیتر است. از نسخه قبلی پشتیبان بگیرید، آدرس نقشه سایت را درست وارد کنید و بعد از تغییر، دسترسی به صفحات مهم را بررسی کنید.
اگر درباره تأثیر یک قانون روی مقالهها، محصولات یا صفحات خدماتتان مطمئن نیستید، در سبکتر میتوانیم ساختار سایت و وضعیت خزش را بررسی کنیم تا تنظیمات بر اساس نیاز واقعی پروژه انجام شود.
آیا همه سایتها به فایل robots.txt نیاز دارند؟
داشتن فایل robots.txt برای همه سایتها الزامی نیست، اما وجود آن میتواند کنترل بیشتری روی نحوه بررسی سایت توسط موتورهای جستجو ایجاد کند. این فایل در سایتهای بزرگ، فروشگاههای اینترنتی و سایتهایی که URLهای زیادی دارند، اهمیت بیشتری پیدا میکند.
چگونه فایل robots.txt را در وردپرس و با افزونهها ویرایش کنیم؟
در وردپرس میتوانید بدون دسترسی مستقیم به فایلهای سرور، robots.txt را از طریق افزونههای سئو مدیریت کنید.
در افزونه Rank Math، از مسیر Rank Math → General Settings → Edit robots.txt میتوانید فایل را مشاهده و قوانین جدید را اضافه کنید.
در افزونه Yoast SEO نیز معمولاً از مسیر Yoast SEO → Tools → File Editor امکان مشاهده و ویرایش robots.txt وجود دارد.
اگر این گزینهها را مشاهده نمیکنید، ممکن است دسترسی ویرایش فایلها روی هاست یا تنظیمات امنیتی سایت محدود شده باشد. قبل از اعمال تغییرات نیز بهتر است قوانین فعلی فایل را بررسی کنید تا دسترسی خزندهها به صفحات مهم سایت به اشتباه محدود نشود.
اشتباهات رایج هنگام تنظیم فایل robots.txt چیست؟
رایجترین اشتباهات شامل مسدود کردن ناخواسته صفحات مهم سایت، استفاده اشتباه از مسیرها، قرار دادن دستورهای پشتیبانینشده مانند noindex داخل robots.txt و جلوگیری کامل از خزش سایت با قانون Disallow: / است. بررسی دقیق قوانین بعد از هر تغییر میتواند از ایجاد مشکلات سئویی جلوگیری کند.
توی این مقاله
برای طراحی سایت، بهتر دیدهشدن یا تولید محتوا، از اینجا شروع کن.