برای تنظیم robots.txt، ابتدا مشخص کنید کدام خزنده نباید کدام مسیر را بررسی کند؛ سپس قوانین را با User-agent و Disallow بنویسید و نتیجه را روی چند آدرس واقعی امتحان کنید. این فایل برای مدیریت خزش است؛ مسدود کردن یک آدرس در آن، بهتنهایی تضمین نمیکند که آن آدرس از نتایج گوگل حذف شود.
فرض کنید فروشگاه شما برای مرتبسازی هر دسته محصول، چندین آدرس متفاوت میسازد. آیا لازم است خزنده بارها همان محصولات را با ترتیبهای مختلف بررسی کند؟ شاید نه. اما قبل از محدود کردن این آدرسها باید مطمئن شوید صفحه مهمی بین آنها نیست. کاربرد robots.txt دقیقاً از همین تصمیمهای کوچک و حسابشده شروع میشود.
در این راهنما، از ساختار ساده فایل شروع میکنیم، سراغ مثالهای قابلاستفاده میرویم و در پایان، روش بررسی تغییرات را مرور میکنیم.
robots.txt چیست و چه کاری انجام میدهد؟
فایل robots.txt یک فایل متنی عمومی است که در ریشه سایت قرار میگیرد و به خزندههای سازگار اعلام میکند کدام مسیرها را بررسی نکنند. نمونه آدرس آن:
https://example.com/robots.txtاین فایل بخشی از سئو تکنیکال سایت است و میتواند برای محدود کردن خزش مسیرهای کماهمیت یا آدرسهای تکراری کاربرد داشته باشد. بااینحال، بیشتر شدن تعداد قوانین به معنی بهتر شدن سئو نیست؛ هر قانون باید دلیل مشخصی داشته باشد.
قبل از هر تغییری، این سه موضوع را از هم جدا کنید:
- مدیریت خزش: میخواهید خزنده یک مسیر را بررسی نکند؛ robots.txt برای این کار است.
- جلوگیری از ایندکس: میخواهید صفحه در نتایج جستجو نمایش داده نشود؛ باید از روش مناسبی مثل
noindexاستفاده کنید. - حفاظت از اطلاعات: میخواهید افراد غیرمجاز به محتوا دسترسی نداشته باشند؛ باید ورود با حساب کاربری یا محدودیت دسترسی سمت سرور داشته باشید.
robots.txt قفل امنیتی نیست و همه رباتها هم الزاماً آن را رعایت نمیکنند. حتی آدرس مسدودشده ممکن است از طریق لینکهای دیگر شناسایی و بدون خواندن محتوایش در نتایج گوگل دیده شود. توضیح گوگل درباره محدودیتهای robots.txt
ساختار فایل robots.txt چگونه است؟
هر گروه با User-agent شروع میشود و قوانین همان خزنده زیر آن قرار میگیرند. این نمونه را ببینید:
User-agent: *
Disallow: /internal-search/
Allow: /internal-search/help.html$

Sitemap: https://example.com/sitemap.xml
معنی خطها به زبان ساده:
User-agent: *گروه عمومی خزندهها را مشخص میکند؛ در ادامه تفاوت آن با گروه اختصاصی را توضیح میدهیم.Disallowخزش یک مسیر را محدود میکند.Allowبرای مجاز کردن یک مسیر، از جمله ایجاد استثنا، استفاده میشود.Sitemapآدرس کامل نقشه سایت را معرفی میکند؛ این خط بهتنهایی باعث ایندکس شدن صفحات نمیشود.
در این مثال، بخش جستجوی داخلی محدود است، اما آدرس دقیق صفحه راهنمای آن استثنا شده است. این فقط یک سناریوی آموزشی است؛ نام مسیرها و نشانی نقشه سایت را متناسب با سایت خودتان تغییر دهید.
اصول نوشتن قوانین robots.txt
هر دستور را در یک خط مستقل بنویسید
چند دستور را پشت سر هم در یک خط ننویسید. نمونه نادرست:
User-agent: * Disallow: /drafts/ Disallow: /internal-search/نسخه صحیح و خواناتر:
User-agent: *
Disallow: /drafts/
Disallow: /internal-search/بین تکتک دستورها به خط خالی نیاز ندارید. میتوانید برای خوانایی، گروههای مختلف را با یک خط خالی جدا کنید. فایل اصلی باید متن ساده با کدگذاری UTF-۸ باشد؛ قالببندی مقاله یا علامتهای حصار کد را داخل فایل واقعی robots.txt کپی نکنید. راهنمای ساخت فایل در مستندات گوگل
مسیرها را دقیق انتخاب کنید
فرض کنید نسخه آلمانی سایت در مسیر /de/ است. این دو قانون معنای یکسانی ندارند:
Disallow: /deDisallow: /de/قانون اول میتواند مسیرهایی مانند /design/ و /delivery/ را هم بگیرد؛ چون آنها نیز با /de شروع میشوند. قانون دوم فقط مسیر /de/ و زیرمسیرهای آن را هدف میگیرد.
اگر آدرس بدون اسلش هم باید پوشش داده شود، آن را جداگانه مشخص کنید:
User-agent: *
Disallow: /de$
Disallow: /de/
همچنین بزرگی و کوچکی حروف در مسیر مهم است؛ /Files/ و /files/ را یکسان فرض نکنید. اگر این بخش هنوز محرمانه یا در حال آمادهسازی است، برای حفاظت واقعی از آن محدودیت دسترسی بگذارید.
از ستاره برای الگوهای تکرارشونده استفاده کنید
علامت * در الگوی مسیر میتواند جای صفر یا چند کاراکتر قرار بگیرد. مثلاً این دستور، آدرسهای دارای پارامتر در مسیر محصولات را پوشش میدهد:
User-agent: *
Disallow: /products/*?
چند نمونه آدرس مشمول این قانون:
/products/t-shirts?color=black
/products/hoodies?size=large
/products/jackets?sort=price
اما آدرس /products/jackets با این الگو مسدود نمیشود؛ چون علامت ? ندارد.
قبل از استفاده، از خودتان بپرسید: آیا همه این پارامترها واقعاً اضافیاند؟ ممکن است یک پارامتر، صفحهای ارزشمند یا بخشی از صفحهبندی فروشگاه را بسازد. پس مسدود کردن همه URLهای پارامتردار، نسخه همیشگی برای هر سایتی نیست.
با علامت دلار، انتهای آدرس را مشخص کنید
علامت $ میگوید الگو باید در انتهای آدرس تمام شود. برای نمونه:
User-agent: *
Disallow: /*.pdf$
این قانون، /files/catalog.pdf را پوشش میدهد؛ اما /files/catalog.pdf?download=1 را نمیگیرد، چون آدرس دوم با .pdf تمام نشده است.
اگر فقط یک فایل مشخص مدنظر شماست، پایان آدرس را صریح بنویسید:
User-agent: *
Disallow: /files/old-catalog.pdf$
این قانون فقط همان آدرس دقیق را هدف میگیرد. نسخه دارای پارامتر یا مسیری مثل /files/old-catalog.pdf.backup تحت این قانون قرار نمیگیرد. بنابراین عبارت «مسدود کردن یک فایل» بدون بررسی شکلهای دیگر آدرس آن میتواند گمراهکننده باشد.
قوانین هر خزنده را کنار هم نگه دارید
بهتر است قوانین مربوط به Googlebot یا هر خزنده دیگر را در یک گروه بنویسید:
User-agent: Googlebot
Disallow: /drafts/
Disallow: /test-pages/
گوگل گروههای تکراری مربوط به همان User-agent را ترکیب میکند، اما مرتب نگه داشتن قوانین، بازبینی فایل را راحتتر میکند.
نکته مهم: گوگل گروه اختصاصی منطبق با خزنده را با گروه عمومی * ادغام نمیکند. اگر برای Googlebot گروه جدا ساختید، محدودیتهای موردنیازش را همانجا هم بنویسید. مثلاً:
User-agent: *
Disallow: /drafts/

User-agent: Googlebot
Disallow: /drafts/
Disallow: /test-pages/
در این نمونه، محدودیت /drafts/ عمداً در هر دو گروه آمده است. قاعده انتخاب گروه و اولویت دستورها در مستندات تفسیر robots.txt توسط گوگل توضیح داده شده است.
برای دلیل هر محدودیت، توضیح کوتاه بنویسید
با # میتوانید کامنت اضافه کنید تا بعداً معلوم باشد چرا یک مسیر محدود شده است:
# Internal search results: avoid repeated crawling
User-agent: *
Disallow: /internal-search/
توضیحی بنویسید که دلیل تصمیم را روشن کند، نه اینکه فقط نام دستور را تکرار کند. کامنتها روی رفتار موتورهای جستجو اثری ندارند و برای کسی هستند که فایل را نگهداری میکند.
محدوده دامنه و زیردامنه را در نظر بگیرید
فایل واقع در https://example.com/robots.txt تنظیمات https://blog.example.com را کنترل نمیکند. برای مدیریت خزش وبلاگ، فایل باید در نشانی خودش در دسترس باشد:
https://blog.example.com/robots.txtمحدوده اعتبار فایل به میزبان، پروتکل و پورت وابسته است. البته اگر یک زیردامنه اصلاً به محدودیت خزش نیاز ندارد، داشتن فایل جداگانه برای آن الزامی نیست.
نمونههای کاربردی robots.txt
نمونههای زیر مستقل از هم هستند. آنها را یکجا در فایل سایت نگذارید؛ ابتدا سناریوی موردنیازتان را انتخاب کنید و بعد مسیرهای واقعی را جایگزین کنید.
۱. اجازه خزش بدون محدودیت
User-agent: *
Disallow:
وقتی بعد از Disallow: مسیری وجود ندارد، این گروه محدودیتی ایجاد نمیکند. این وضعیت به معنی تضمین خزش یا ایندکس همه صفحات نیست؛ فقط مانعی از طرف این قانون وجود ندارد.
۲. جلوگیری از خزش کل سایت
User-agent: *
Disallow: /
این قانون همه مسیرها را برای خزندههای مشمول گروه محدود میکند. اگر سایت عمومی شما باید در جستجو دیده شود، چنین قانونی معمولاً با هدفتان سازگار نیست. در فایلهایی که گروه اختصاصی دارند، همان گروهها را هم بررسی کنید.
برای محیط آزمایشی نیز به این دستور اکتفا نکنید؛ دسترسی با رمز یا کنترل دسترسی مناسب، مانع دیدن محتوای منتشرنشده توسط افراد غیرمجاز میشود.
۳. محدود کردن یک پوشه و آزاد گذاشتن یک صفحه
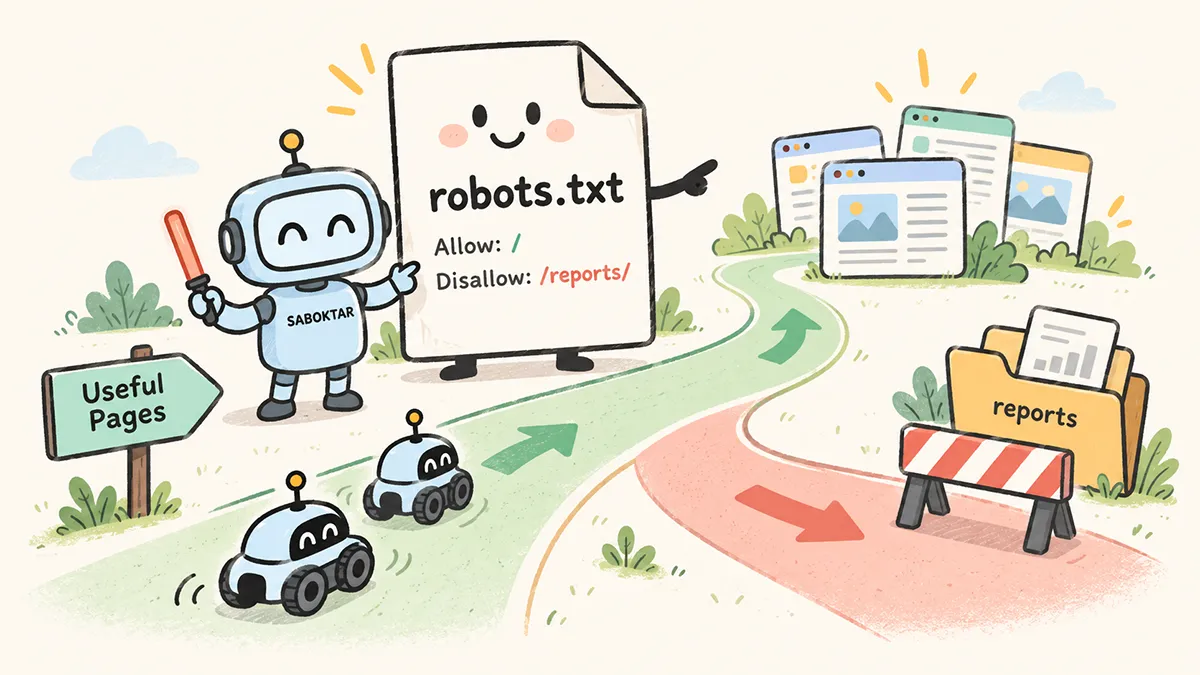
فرض کنید مسیر /reports/ گزارشهای موقتی دارد، اما صفحه راهنمای آن باید قابلخزش باشد:
User-agent: *
Disallow: /reports/
Allow: /reports/help.html$
نتیجه موردانتظار:
/reports/monthly.html: خزش محدود میشود./reports/archive/2026.html: خزش محدود میشود./reports/help.html: خزش مجاز است./reports/help.html?print=1: همچنان زیر محدودیت پوشه قرار میگیرد؛ چون با استثنای دقیق مطابقت ندارد.
در تفسیر گوگل، قانون مشخصتر اولویت دارد؛ اگر دو قانون متعارض همارز باشند، قانون مجازکننده اعمال میشود. جابهجا کردن خطها راه تعیین اولویت نیست.
۴. محدود کردن PDFها با در نظر گرفتن پارامتر
اگر هم فایلهای PDF و هم نسخه دارای پارامتر آنها را میخواهید هدف بگیرید:
User-agent: *
Disallow: /*.pdf$
Disallow: /*.pdf?
برای مثال، هم /downloads/guide.pdf و هم /downloads/guide.pdf?version=2 مشمول این الگوها هستند. پسوند بزرگ .PDF را در صورت وجود جداگانه بررسی کنید.
اگر هدف، حذف PDF از نتایج گوگل است، این نمونه راهحل مناسبی نیست. برای فایلهایی مثل PDF میتوان هدر X-Robots-Tag: noindex را در پاسخ سرور تنظیم کرد؛ خزنده باید بتواند فایل را درخواست کند تا هدر را ببیند. راهنمای noindex برای صفحات و فایلها
۵. محدود کردن یک پارامتر مشخص بهجای همه پارامترها
فرض کنید فقط آدرسهای مرتبسازی با sort اضافهاند، اما صفحهبندی با page باید قابلخزش بماند. میتوانید الگو را محدودتر بنویسید:
User-agent: Googlebot
Disallow: /products/*?sort=
Disallow: /products/*?*&sort=
خط اول، sort را وقتی اولین پارامتر باشد میگیرد؛ خط دوم، وقتی بعد از پارامتر دیگری آمده باشد. نمونهها:
/products/shoes?sort=price: خزش محدود است./products/shoes?color=black&sort=price: خزش محدود است./products/shoes?page=2: این دو قانون آن را محدود نمیکنند.
این الگو را با ساختار آدرسهای سایت خودتان امتحان کنید. اگر گروه Googlebot از قبل وجود دارد، قوانین را به همان گروه اضافه کنید و محدودیتهای ضروری دیگر را هم نگه دارید.
نمونه اولیه robots.txt برای وردپرس
اگر سایت وردپرس دارید، یک نقطه شروع ساده برای سایت نصبشده در ریشه دامنه میتواند چنین باشد:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
قبل از استفاده، این موارد را بررسی کنید:
- دامنه نمونه را با دامنه واقعی خودتان جایگزین کنید.
- آدرس نقشه سایت را باز کنید؛ همه سایتها از
sitemap_index.xmlاستفاده نمیکنند. - اگر وردپرس در زیرپوشه نصب شده، مسیرها را متناسب با همان نصب تغییر دهید.
- پوشههای قالب، افزونهها، تصاویر، CSS و JavaScript را بدون بررسی مسدود نکنید؛ منابع لازم برای نمایش صفحه باید در دسترس خزنده باشند.
- محدود کردن
/wp-admin/جایگزین امنیت صفحه ورود یا مدیریت سایت نیست.
این نمونه «بهترین robots.txt برای همه سایتهای وردپرسی» نیست. فروشگاه، وبلاگ یا سایت چندزبانه ممکن است نیازهای متفاوتی داشته باشد. ملاک، خروجی واقعی فایل و ساختار سایت شماست.
چطور تنظیمات robots.txt را بررسی کنیم؟
بهجای اینکه فقط ظاهر فایل را نگاه کنید، تغییر را با چند آدرس واقعی بسنجید:
- نسخه قبلی را نگه دارید. دلیل تغییر و مسیرهای مدنظر را هم یادداشت کنید.
- فایل نهایی را در مرورگر باز کنید. در آدرس
/robots.txtباید متن قوانین دیده شود؛ نه صفحه خطا یا محتوای سایت. - آدرسهای حساس را فهرست کنید. صفحه اصلی، یک محصول، یک مقاله و منابع ضروری صفحه را در نظر بگیرید.
- برای هر قانون، نمونه مثبت و منفی داشته باشید. مثلاً در قانون
sort، یک URL مرتبسازی باید محدود شود و یک URL صفحهبندی باید آزاد بماند. - گروه خزنده را مشخص کنید. نتیجه را فقط با دیدن گروه
*قضاوت نکنید؛ ممکن است Googlebot گروه اختصاصی داشته باشد. - پس از انتشار، وضعیت دریافت فایل را بررسی کنید. گزارش robots.txt سرچ کنسول برای بررسی دریافت فایل و خطاهای آن کاربرد دارد. راهنمای گزارش robots.txt در سرچ کنسول
مجاز بودن در robots.txt فقط یکی از شروط دسترسی است. خطای سرور، الزام ورود یا محدودیتهای دیگر هم میتوانند جلوی دریافت صفحه را بگیرند.
اشتباههایی که بهتر است از آنها دوری کنید
- استفاده از robots.txt برای حذف صفحه از گوگل: محدودیت خزش با جلوگیری از ایندکس فرق دارد.
- مسدود کردن صفحه دارای noindex: گوگل برای دیدن noindex باید به صفحه دسترسی داشته باشد.
- کپی کردن فایل یک سایت دیگر: پوشهها و پارامترهای آن سایت الزاماً شبیه سایت شما نیستند.
- محدود کردن تمام پارامترها بدون بررسی: ممکن است صفحات کاربردی هم از دسترس خزنده خارج شوند.
- نوشتن مسیر بیش از حد کلی: تفاوت
/deو/de/را فراموش نکنید. - فراموش کردن تنظیمات آزمایشی بعد از انتشار: پیش از عمومی شدن سایت، وجود
Disallow: /و سایر محدودیتها را بررسی کنید.
پرسشهای متداول
آیا همه سایتها باید فایل robots.txt داشته باشند؟
خیر. اگر محدودیتی برای خزش ندارید، صرفاً برای مجاز کردن خزندهها به این فایل نیاز ندارید. بااینحال، میتوانید از آن برای معرفی نقشه سایت و مدیریت نیازهای مشخص خزش استفاده کنید.
آیا مسدود کردن یک صفحه، دستور noindex آن را هم بیاثر میکند؟
اگر خزنده بهدلیل robots.txt نتواند صفحه را دریافت کند، نمیتواند noindex داخل آن را ببیند. برای خارج کردن صفحه با این روش، اجازه خزش را حفظ کنید تا گوگل دستور را پردازش کند.
آیا گذاشتن آدرس در نقشه سایت، محدودیت robots.txt را برمیدارد؟
خیر. معرفی URL در نقشه سایت، مجوز عبور از قانون Disallow نیست. آدرسهای نقشه سایت و تنظیمات خزش را با هدف انتشار همان صفحات هماهنگ کنید.
آیا robots.txt به دیده شدن در پاسخهای هوش مصنوعی کمک میکند؟
دسترسی خزنده یکی از پیشنیازهای فنی است، اما مجاز کردن خزش، نمایش یا استناد به محتوا را تضمین نمیکند. درباره AI Overviews و AI Mode گوگل، همان اصول سئو و محتوای مفید برقرار است و الزام فنی یا اسکیمای ویژهای برای حضور وجود ندارد. سیاست سایر سرویسها را باید از مستندات همان سرویس بررسی کرد. راهنمای گوگل درباره قابلیتهای هوش مصنوعی و وبسایتها
جمعبندی مقاله
برای تنظیم درست robots.txt، اول هدف را روشن کنید: کدام آدرس نباید خزیده شود و چرا؟ سپس دقیقترین قانون لازم را بنویسید و آن را روی آدرسهای هدف و چند صفحه مهم دیگر بررسی کنید.
یک فایل کوتاه و قابلفهم که با ساختار واقعی سایت هماهنگ باشد، نگهداری آسانتری دارد. اگر هم هدفتان حذف محتوا از نتایج جستجو یا حفاظت از اطلاعات است، سراغ ابزار مناسب همان کار بروید؛ robots.txt فقط بخشی از مدیریت فنی سایت است.
توی این مقاله
برای طراحی سایت، بهتر دیدهشدن یا تولید محتوا، از اینجا شروع کن.